为什么 DeepSeek网页版 采用「顶栏公告无头页」架构:告别臃肿页头,让深度对话从第一像素直接开始
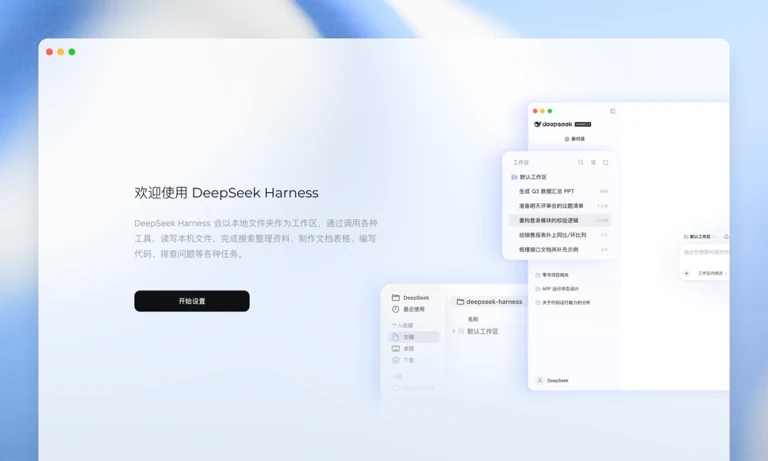
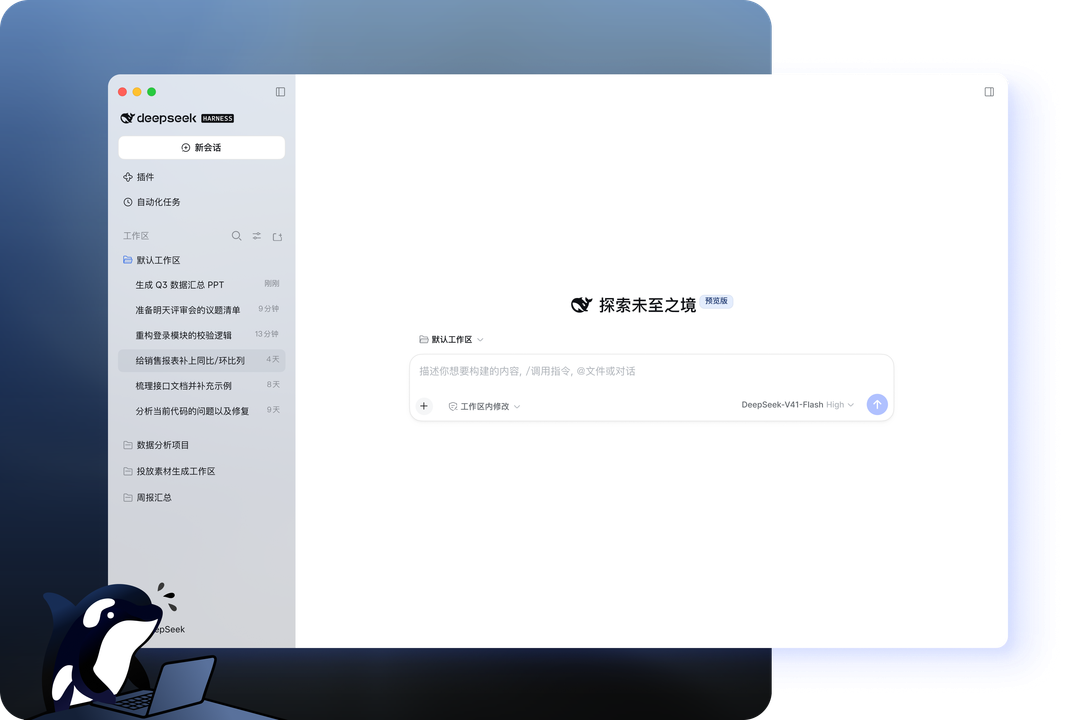
在传统企业门户网站中,层层叠叠的巨型下拉菜单(Mega Menu)和横跨半屏的装饰性横幅往往占据了用户宝贵的首屏视野。而在以高频推理和沉浸式思考为核心的 AI 时代,用户打开页面的唯一诉求就是立刻开始对话或调阅接口。因此,DeepSeek官网 与 DeepSeek网页版 在本套设计中大胆采用「顶栏公告无头页(Headless Ticker Page)」架构:砍掉笨重的传统 header,仅保留一条轻盈的半透明滚动公告条——「DeepSeek官网 · 网页版已开放 · API开放平台 · Harness」,让正文与交互预览从第一像素直接开始。
与此同时,我们将全页面的章节跳转浓缩为屏幕右侧的一列极简「侧点锚点(Side Dots)」。当用户在阅读 DeepSeek R1深度思考模型 与 DeepSeek V3满血版在线使用 的技术细节时,视线完全不会被顶部繁杂的选项卡打断;只需指尖轻移右侧圆点,即可在首屏对话预览、四节点矩阵、能力卡片与深度长文之间瞬移切换。
一、滚动公告条四大关键词背后的完整产品生态
- DeepSeek官网(探索未至之境):汇聚深度求索最新基础模型论文、开源权重仓库与技术路线图,坚持以架构创新突破算力效率极限。
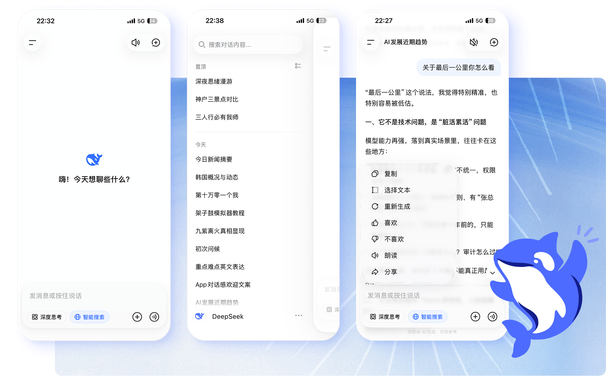
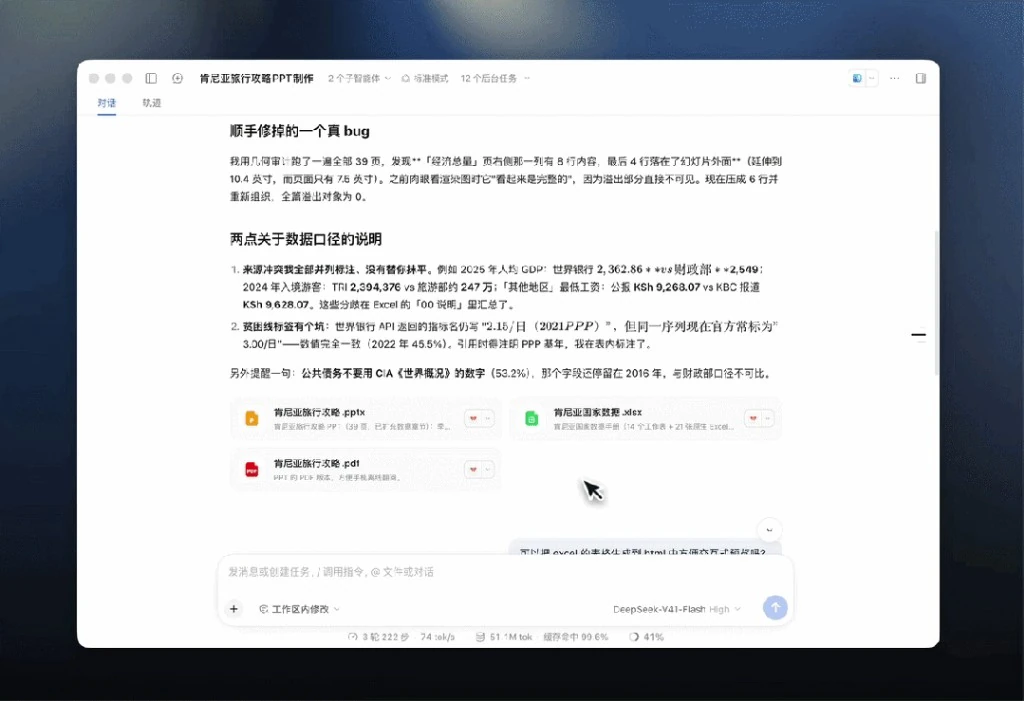
- 网页版已开放(DeepSeek深度对话在线入口):面向所有用户的免费在线工作台,支持一键开启 R1 深度思考、全网实时搜索与 128K 超长附件解析。
- API开放平台(DeepSeek api开放平台):提供兼容 OpenAI 协议的
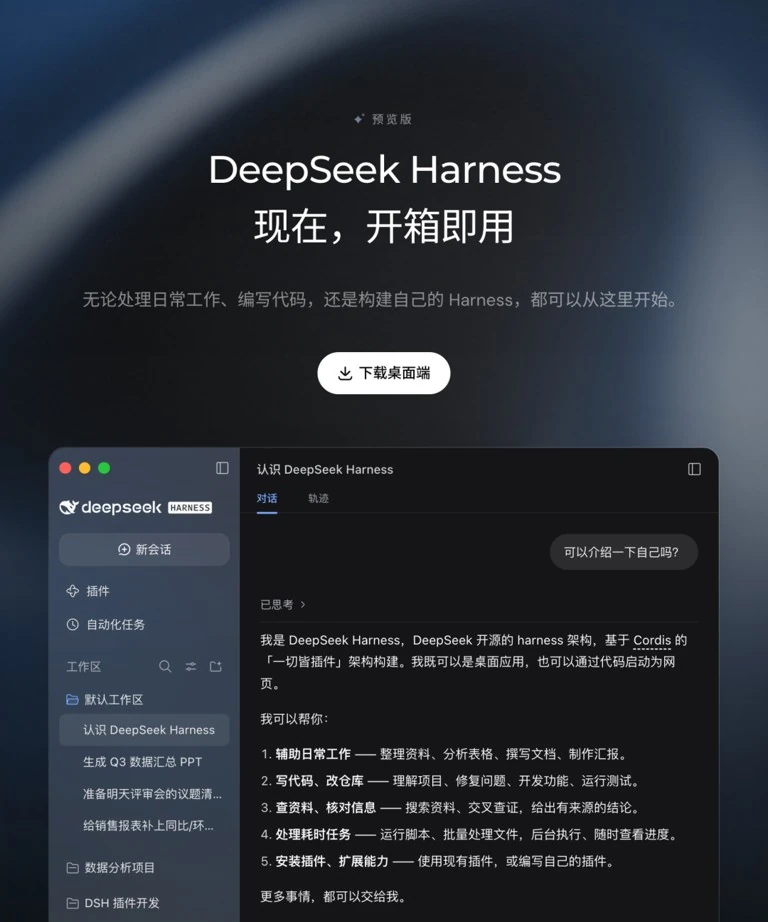
deepseek-chat与deepseek-reasoner接口,硬盘缓存命中低至 0.1 元/百万 Tokens。 - Harness(DeepSeek Harness):面向科研与工程团队的标准化评测脚手架,支持本地沙箱复现 92.6% 的 MATH-500 数学推理得分。
二、DeepSeek深度对话在线入口如何重塑科研与工程工作流?
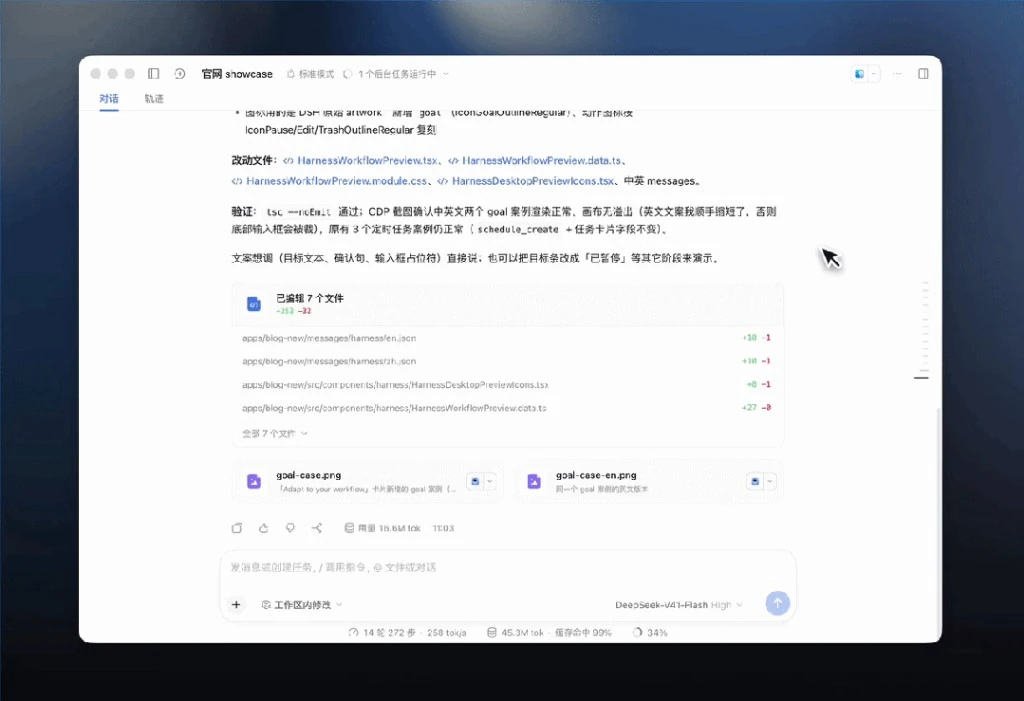
无论是推导高维偏微分方程、审计数万行 Rust/C++ 系统代码,还是提炼百页行业研究报告,DeepSeek AI 的「深度对话」能力都建立在原生强化学习激发的长思维链之上。点击顶栏滚动公告中的「网页版已开放」或右侧第五颗锚点圆点,即刻进入 DeepSeek网页版入口,在零干扰的无头纯净页面中探索未至之境。